
La pregunta suele llegar así: «¿qué hago para que ChatGPT me cite?». La respuesta honesta es que nadie puede garantizarlo, porque ni OpenAI ni Perplexity documentan un método para conseguir una cita. Lo que sí documentan es qué bots leen tu web y para qué. Así que el trabajo real tiene tres partes: dejar entrar a los bots que buscan, que cada página se entienda sola y medir si te llegan visitas y leads.
Y sí, esto lo escribe Clientify. Por eso cada afirmación sobre un bot lleva el enlace a la página oficial donde la leí: no tienes que creerme, puedes ir y comprobarlo. Y por eso enseño nuestro propio robots.txt, con lo que encontré al revisarlo.
¿Qué bots de OpenAI y Perplexity leen tu web y para qué?
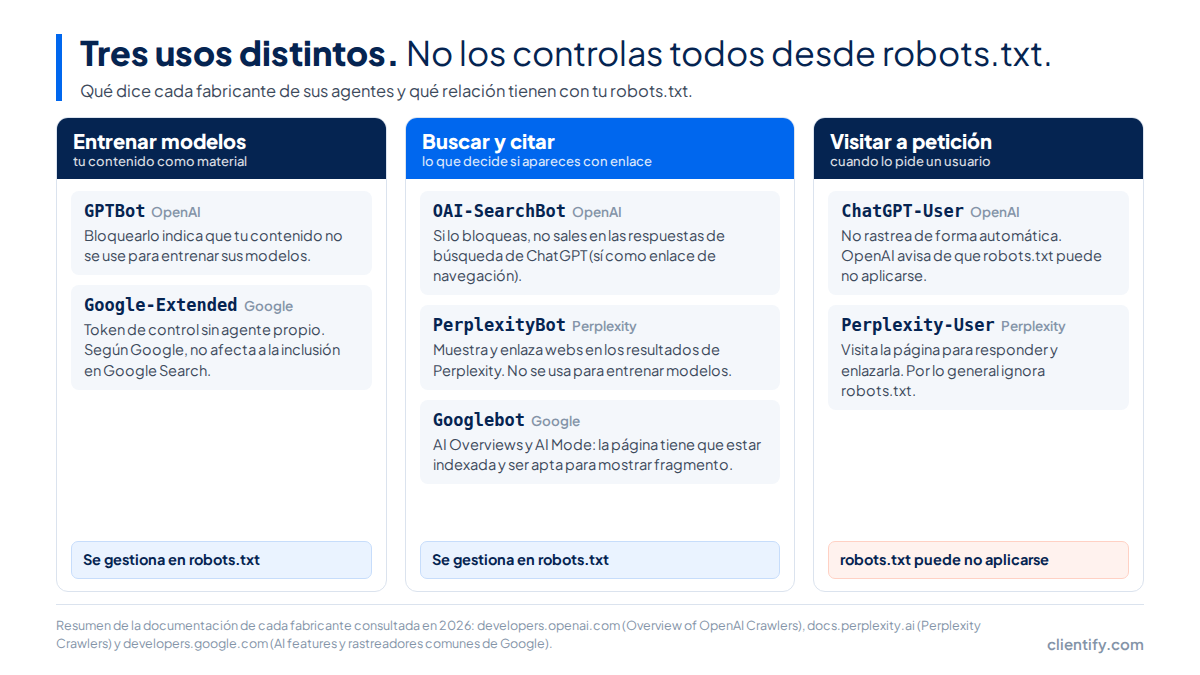
Tu web la leen tres tipos de agentes, cada uno para una cosa distinta: los que recogen contenido para entrenar modelos, los que alimentan la búsqueda del asistente y los que visitan una página cuando un usuario lo pide. Confundirlos es la forma más rápida de bloquear justo lo que no querías.
OpenAI tiene uno de cada. GPTBot recoge contenido para entrenar sus modelos. OAI-SearchBot sirve para mostrar webs en la búsqueda de ChatGPT, y si lo bloqueas no apareces en esas respuestas. ChatGPT-User visita páginas cuando alguien se lo pide dentro de ChatGPT. Está todo en su página de rastreadores.
Perplexity separa dos. PerplexityBot muestra y enlaza webs en sus resultados y, según la propia empresa, no se usa para entrenar modelos. Perplexity-User visita la página cuando alguien hace una pregunta, para responder y enlazarla. Lo cuenta en su documentación de rastreadores.
Ojo con esto: bloquear GPTBot no te saca de la búsqueda de ChatGPT. OpenAI lo dice con todas las letras: cada ajuste es independiente, y un sitio puede permitir OAI-SearchBot para aparecer en los resultados mientras bloquea GPTBot. Si cerraste la puerta a GPTBot pensando en ChatGPT, lo que decide tu visibilidad ahí es otro agente.
| Agente | Fabricante | Para qué lo usa | Relación con robots.txt |
|---|---|---|---|
GPTBot |
OpenAI | Entrenar sus modelos fundacionales de IA generativa. | Bloquearlo indica que tu contenido no debe usarse para entrenar esos modelos. |
OAI-SearchBot |
OpenAI | Mostrar webs en las funciones de búsqueda de ChatGPT. | Si lo bloqueas, no sales en las respuestas de búsqueda de ChatGPT, aunque puedes aparecer como enlace de navegación. |
ChatGPT-User |
OpenAI | Acciones que inicia un usuario. No rastrea la web de forma automática. | Robots.txt puede no aplicarse. No decide si apareces en la búsqueda. |
PerplexityBot |
Perplexity | Mostrar y enlazar webs en los resultados de Perplexity. No se usa para entrenar modelos. | Se gestiona en robots.txt. Perplexity recomienda permitirlo para aparecer. |
Perplexity-User |
Perplexity | Visitar una página cuando un usuario hace una pregunta, para responder y enlazarla. | Por lo general ignora robots.txt, porque la visita la pide el usuario. |
Google-Extended |
Token para entrenar futuras generaciones de Gemini y para el grounding. No tiene cadena de agente propia. | Se escribe en robots.txt. No afecta a la inclusión en Google Search ni al ranking. | |
Googlebot |
Google Search, incluidos AI Overviews y AI Mode. | Sus directivas en robots.txt son el control de acceso para Search. |
Eso sí, los agentes que actúan a petición del usuario juegan con otras reglas. OpenAI avisa de que, como esas acciones las inicia una persona, robots.txt puede no aplicarse a ChatGPT-User. Perplexity va más lejos y dice que Perplexity-User por lo general ignora robots.txt. Si tu objetivo es que un contenido no llegue a ningún asistente, robots.txt por sí solo no te lo asegura.
Hay una pieza más que despista: el cortafuegos. Perplexity advierte de que, si usas un WAF, puede que tengas que dar permiso explícito a sus bots. Y los dos fabricantes publican los rangos de IP de cada agente, como el searchbot.json de OpenAI, para que puedas identificarlos en tus registros.
¿Cómo comprobé nuestro robots.txt?
Descargué el robots.txt de clientify.com tal como lo sirve el servidor y lo leí línea a línea con la documentación de cada fabricante al lado. La regla de fondo es sencilla: si no puedo abrir la página oficial y leer con mis ojos cómo trata un agente ese fichero, no publico qué hace.
Para interpretar los grupos usé dos textos: la RFC 9309, que es el estándar de robots.txt, y la especificación de robots.txt de Google. Este es el fichero que encontré:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: *?*
Allow: /*.css?*
Allow: /*.js?*
User-agent: GPTBot
Allow: /
User-agent: PerplexityBot
Allow: /
User-agent: ClaudeBot
Allow: /
User-agent: GoogleExtended
Allow: /
Sitemap: https://clientify.com/sitemap_index.xml
Ninguno de los hallazgos es grave, pero hay cuatro cosas que revisar:
OAI-SearchBotno tiene grupo propio. Hay grupos paraGPTBotyPerplexityBot, pero no para el agente de búsqueda de OpenAI ni para los dos agentes de usuario. Según la RFC, un rastreador sin grupo que le corresponda obedece el del asterisco, así queOAI-SearchBotlee nuestra web con las mismas reglas que cualquier otro bot.- Los grupos propios no heredan las reglas del asterisco.
GPTBotyPerplexityBottienen un grupo conAllow: /, y eso significa que no siguen las reglas del grupo*: ni la de/wp-admin/ni la de parámetros. - El grupo
GoogleExtendedno escribe el token como lo documenta Google, que esGoogle-Extended, con guion. - La línea
Disallow: *?*es una regla que pretende bloquear las URLs con parámetros. Antes de copiarla a otros grupos, hay que comprobar que hace lo que se espera de ella.
Un bot con grupo propio no hereda las reglas del asterisco. La RFC 9309 dice que un rastreador sin grupo que le corresponda debe obedecer el grupo *. Google lo resume así: los grupos específicos de un agente y el grupo global no se combinan.
Por eso, en nuestro fichero, GPTBot y PerplexityBot no siguen ni Disallow: /wp-admin/ ni la regla de parámetros. Y OAI-SearchBot, que no tiene grupo, sigue el del asterisco: puede leer las URLs normales, pero no las que esa regla pretende bloquear.
Con eso delante, esta es la versión que propondría. Reúne a los bots de IA en un solo grupo con varias líneas User-agent, les aplica la misma exclusión de administración que al resto y deja la regla de parámetros marcada como pendiente, porque tocarla afecta a todo el sitio.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
# Pendiente: revisar la regla de parámetros
Disallow: *?*
Allow: /*.css?*
Allow: /*.js?*

User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: PerplexityBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Allow: /

Sitemap: https://clientify.com/sitemap_index.xml
Todavía no está aplicada en clientify.com. Si cambias el tuyo, ten en cuenta los plazos: OpenAI habla de unas 24 horas para que su búsqueda se ajuste, Perplexity de hasta 24 horas, y Google explica que por lo general guarda el fichero en caché hasta 24 horas.
¿Y Google AI Overviews y AI Mode?
En Google no hay un bot aparte ni un requisito extra: si una página está indexada y puede mostrarse en la Búsqueda con fragmento, ya puede salir como enlace en AI Overviews y AI Mode. Lo dice su guía sobre las funciones de IA: no hay requisitos técnicos adicionales ni optimizaciones especiales.
Eso no significa que vayas a salir. La misma guía recuerda que ni la indexación ni la aparición están garantizadas, y que los AI Overviews solo se muestran cuando sus sistemas creen que aportan algo a la búsqueda clásica, así que a menudo no aparecen.
El control sigue siendo el de siempre. Google explica que la IA forma parte de la Búsqueda y que las directivas de robots.txt para Googlebot son las que gestionan el rastreo. Si quieres limitar lo que se muestra de tus páginas, las herramientas son nosnippet, data-nosnippet, max-snippet o noindex.
Google-Extended es otra cosa. Es un token que se escribe en robots.txt para decidir si tu contenido se usa para entrenar futuras generaciones de Gemini y para el grounding. Según la página de rastreadores comunes de Google, no afecta a tu inclusión en Google Search ni se usa como señal de ranking.
¿Qué hace que una página sea citable?
Nadie publica una fórmula, y por eso circulan tantas. Lo más útil que encontré es la lista de buenas prácticas que Google da para sus funciones de IA, que en realidad son las de siempre: permitir el rastreo en robots.txt y en tu CDN o hosting, que el contenido se encuentre desde enlaces internos, una buena experiencia de página, lo importante en texto y datos estructurados que coincidan con lo que se ve.
Antes de cambiar nada por un consejo que circula, merece la pena compararlo con lo que dicen los fabricantes. Revisé las tres páginas oficiales buscando los que más se repiten:
| Lo que circula | Qué dice la documentación oficial | Qué haría |
|---|---|---|
| «ChatGPT cita lo que está en Bing» | La página de agentes de OpenAI no menciona Bing. Lo que documenta es OAI-SearchBot. |
Permitir OAI-SearchBot y comprobar qué grupo sigue. |
| «Hay que estar en Reddit» | No aparece como recomendación en ninguna de las tres páginas. | No lo trataría como requisito técnico. |
| «Crea un llms.txt» | OpenAI y Perplexity lo usan como índice de su propia documentación. Google dice que no hace falta crear archivos de texto para IA. | Revisar antes robots.txt, CDN y enlazado interno. |
| «Responde en 40 a 60 palabras» | No aparece en ninguna de las tres páginas. | Respuestas cortas donde ayuden a leer, sin tomarlo como regla. |
| «Añade un schema especial para IA» | Google dice que no hay datos estructurados especiales que añadir y pide que coincidan con el texto visible. | Marcado honesto, igual al texto de la página. |
Que algo no aparezca en la documentación no lo convierte en falso: solo significa que no hay una fuente oficial que lo respalde. Donde sí hay texto claro es en Google, que dice dos cosas sin matices: no hace falta crear archivos nuevos para máquinas ni archivos de texto para IA, y no hay datos estructurados especiales que añadir para salir en estas funciones.
El marcado sigue sirviendo para que la página se entienda, siempre que describa lo que el lector ve. Lo contamos con más detalle en la guía sobre el marcado schema y los LLM.
Acá va una costumbre práctica que aplicamos en el blog: cada apartado responde a su pregunta en las dos primeras frases. No porque lo pida ningún fabricante, sino porque un lector con prisa se queda con eso y decide si sigue leyendo.
¿Cómo medir si ChatGPT o Perplexity te mandan visitas?
La cita no se ve desde fuera, pero la visita sí. En Google Analytics 4, lo más directo es una exploración con la dimensión «Fuente de la sesión» filtrada por chatgpt.com o perplexity.ai. Si tu propiedad recoge más de un dominio, añade el filtro de nombre de host: en la nuestra, sin él, los números mezclaban webs.
No te quedes solo con el canal AI Assistant. De las sesiones que chatgpt.com mandó a clientify.com en los ocho primeros meses de 2026, 737 cayeron en AI Assistant, 1.063 en Referral, 1.018 en Unassigned y 7 en Organic Search. El reparto por canal no suma exactamente el total por fuente, pero la conclusión no cambia: la mayoría no estaba en el canal de IA.
En total fueron 2.772 sesiones desde chatgpt.com, el 0,28 % de las 978.111 que tuvo el sitio en ese periodo, y 389 entraron por una página del blog. Perplexity mandó 327, y 151 de ellas entraron por el blog. Son cifras pequeñas y hay que decirlo, pero ya se pueden medir y seguir mes a mes.
La entrada del blog por la que más sesiones llegaron desde asistentes fue la comparativa del mejor CRM para WhatsApp, con 44 sesiones. Por eso merece la pena mirar el dato antes de suponer qué contenido interesa a quien pregunta a un asistente.
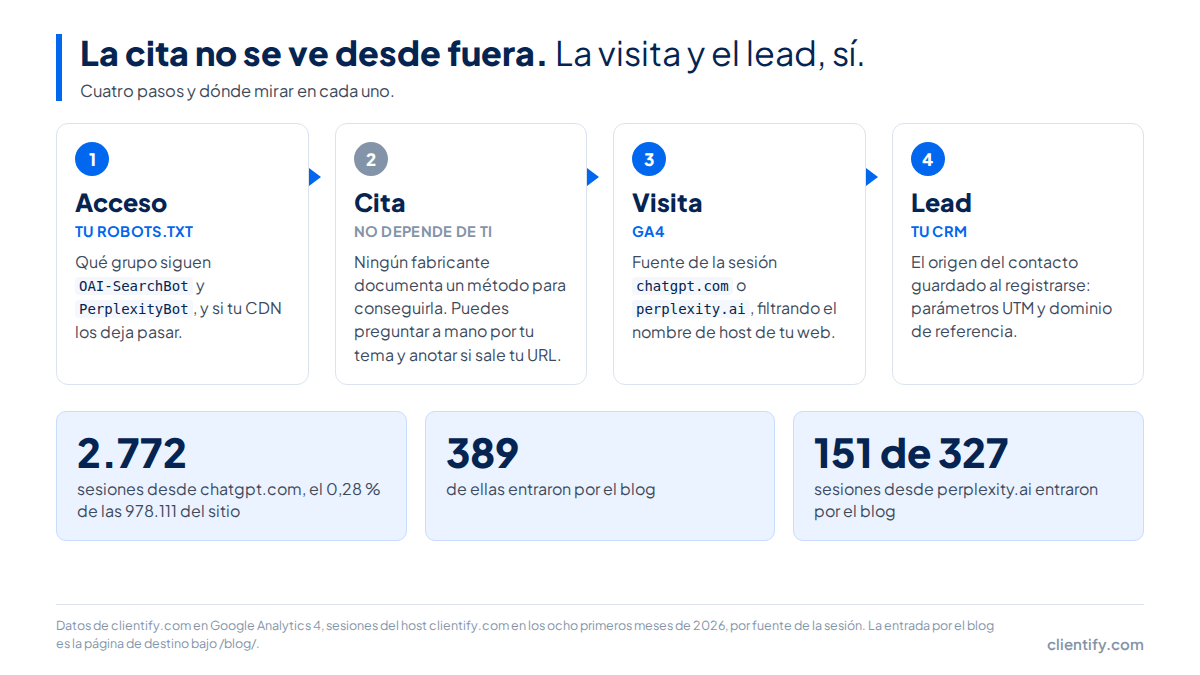
La visita es solo la mitad. Lo que importa es si esa persona acaba dejando sus datos, y para eso hace falta el CRM. Explicamos el cruce paso a paso en la guía para cruzar GA4 con el CRM.
Una advertencia antes de sacar conclusiones: alguien puede leer la respuesta de ChatGPT, no hacer clic y buscarte después en Google. Esa visita llegará con Google como fuente, no con chatgpt.com, así que lo que ves en GA4 es un mínimo, no el total de la influencia de los asistentes.
Cómo se resuelve con Clientify
En Clientify, la parte del lead se apoya en dos campos que no hay que confundir y en un aviso sobre formularios que ahorra muchas dudas cuando los números no cuadran.
Del referrer al contacto, en Clientify
Canal Online. Lo rellena el píxel de Clientify con los UTM y los datos de navegación, toma como referencia la primera visita a tu web y no se puede editar a mano. Entre los canales que distingue está «Herramienta IA».
Origen del Contacto. Es otro campo: dice por dónde se registró el contacto (formulario, chatbot, WhatsApp…), no cómo llegó. Por eso no siempre coinciden: miden momentos distintos del recorrido.
Nuestro dato. De los 36.383 contactos creados en nuestra cuenta en los ocho primeros meses de 2026, 88 (el 0,24 %) llegaron desde un asistente de IA, 80 de ellos desde ChatGPT. Contamos como tales los que traen ChatGPT, OpenAI, Perplexity, Gemini, Copilot, Claude, DeepSeek o Mistral en el referrer o en la UTM de origen, o el medio ai-tools.
Un matiz sobre los formularios externos: el píxel de Clientify no puede seguir la visita si el formulario no es de Clientify. Lo explica la guía del píxel, y las diferencias entre los dos campos están en este artículo de ayuda.
Si además usas asistentes en el trabajo comercial del día a día, tenemos una guía de prompts de IA para ventas con ejemplos para cada fase.
Preguntas frecuentes sobre ChatGPT, Perplexity y robots.txt
¿Bloquear GPTBot me saca de la búsqueda de ChatGPT?
No. OpenAI explica que cada ajuste es independiente: GPTBot indica si tu contenido puede usarse para entrenar modelos, y OAI-SearchBot controla si apareces en las respuestas de búsqueda de ChatGPT. Puedes bloquear el primero y permitir el segundo. Revisa qué grupo de tu robots.txt sigue OAI-SearchBot, porque si no tiene uno propio aplica el grupo del asterisco.
¿Perplexity respeta el robots.txt?
Depende del agente. PerplexityBot, el que muestra y enlaza webs en sus resultados, se gestiona desde robots.txt, y Perplexity recomienda permitirlo si quieres aparecer. Perplexity-User, que visita una página cuando un usuario hace una pregunta, por lo general ignora robots.txt según su propia documentación, porque la visita la pide una persona.
¿Necesito un archivo llms.txt para que me citen?
Ninguna de las documentaciones que revisé lo pide. OpenAI y Perplexity mencionan llms.txt como índice de su propia documentación, y Google dice que no hace falta crear archivos de texto para IA ni marcado especial para salir en AI Overviews o AI Mode. Antes de eso, revisa tu robots.txt, lo que deja pasar tu CDN y el enlazado interno.
¿Cuánto tarda en aplicarse un cambio en robots.txt?
Cada fabricante da su plazo. OpenAI indica que sus sistemas pueden tardar unas 24 horas en ajustarse para los resultados de búsqueda; Perplexity habla de hasta 24 horas, y Google explica que por lo general guarda en caché el robots.txt hasta 24 horas. Si cambias algo, espera al menos un día antes de sacar conclusiones.
¿Cómo veo en GA4 las visitas que manda ChatGPT?
Crea una exploración con la dimensión «Fuente de la sesión» y filtra por chatgpt.com o perplexity.ai, añadiendo el nombre de host de tu web si la propiedad recoge varios dominios. No te quedes solo con el canal AI Assistant: en clientify.com, buena parte de las sesiones desde chatgpt.com caía en Referral o Unassigned.
¿Por dónde empiezo?
Si haces solo una cosa hoy, que sea abrir tu robots.txt y buscar qué grupo sigue OAI-SearchBot. Si no tiene uno propio, lee qué dice el grupo del asterisco. Si lo tiene, comprueba que no lo estás bloqueando sin querer.
Después, deja guardada la exploración de GA4 con la fuente de la sesión y el nombre de host, y revisa en tu CRM el canal de los contactos nuevos. Acá no hay atajos: con esos dos datos sabrás si los asistentes te mandan visitas que acaban en leads.
¿Te llegan leads desde ChatGPT? Míralo en tu CRM
7 días de prueba de Clientify, sin tarjeta. Conecta tus formularios y mira de dónde llega cada contacto nuevo.